如果你问一个农户:"这片叶子怎么了?"
他可能会凑近看看,然后告诉你:
"这是黄龙病,得赶紧处理,不然整片园子都要遭殃。"
但如果你把这张照片发给 AI,得到的回复可能是:
"叶片出现黄化现象,可能存在病虫害,建议加强田间管理。"
听起来没错,但没什么用。
农户早就知道要加强管理,他想知道的是:
到底是什么病?用什么药?今天要不要处理?
这就是我做农业 AI 识别这三个月,遇到的最大挑战。
最开始,我的思路很简单:
用户拍照 → 上传云端 → 调用大模型 → 返回诊断结果
技术上完全跑得通,小程序一周就上线了。
但测试数据很快给了我一盆冷水:
| 测试场景 | 识别准确率 | 用户满意度 |
| 作物种类识别 | 95% | 高 |
| 表面症状描述 | 85% | 中 |
| 具体病害诊断 | 42% | 低 |
| 防治方案建议 | 32% | 很低 |
问题出在哪里?
我收集了早期版本的 100 条诊断记录,发现一个规律:
AI 给出的回答大多是这样的:
"叶片出现黄色斑点,可能是由多种原因引起的,包括营养缺乏、病虫害感染或环境因素。建议您观察病情发展,必要时咨询当地农技人员。"
这段话有问题吗?
从技术角度看,完全正确。
但从农户角度看,等于没说。
就像一个病人问医生:"我这是什么病?"
医生回答:"你可能生病了,也可能是其他原因,建议你观察一下。"
患者会怎么想?
为什么农业病害识别这么难?
我后来意识到,这和普通的图像识别完全是两个维度的问题。
普通图像识别:
输入:一张清晰的照片
输出:这是黄叶病,黄龙病
判断依据:外观特征明显,类别边界清晰
农业病害识别:
同样是黄叶:
可能是缺氮
可能是肥害
可能是积水烂根
可能是黄龙病早期
可能是药害
同样是斑点:
可能是炭疽病
可能是溃疡病
可能是叶枯病
可能是高温灼伤
甚至可能是拍摄时的反光误判
没有足够的上下文信息,光看一张照片,神仙也难断。
意识到问题后,我决定重构整个系统。
核心思路:不让大模型单独做诊断,而是让它做它擅长的事。
新架构设计:
│用户拍照 → YOLO 快速检测 → 大模型分析→ 知识库匹配 (定位 + 初筛) │ │ (深度推理) │(生成方案) │输入毫秒级响应结合上下文标准化输出
YOLO(You Only Look Once)系列模型有几个关键优势:
速度优势
传统目标检测模型(如 Faster R-CNN)需要两阶段处理:
生成候选区域
对每个区域分类
YOLO 只需要一次前向传播就能完成检测和分类。
在实际测试中:
| 模型 | 单张图片处理时间 | 可部署性 |
| Faster R-CNN | 800-1200ms | 需要 GPU |
| YOLOv8 | 80-150ms | 手机可运行 |
| YOLOv10 | 50-100ms | 手机可运行 |
对于田间地头的农户来说,3 秒和 0.1 秒的体验差距是巨大的。
精度表现
我在自建的数据集上做了对比测试(5000 张标注图片):
| 模型 | mAP@0.5 | mAP@0.5:0.95 | 早期病斑检出率 |
| 大模型零样本 | 0.38 | 0.22 | 41% |
| YOLOv8 微调 | 0.82 | 0.67 | 76% |
| YOLOv10 微调 | 0.85 | 0.71 | 79% |
注意:这里的"大模型零样本"是指直接用 GPT-4V 等模型不做微调的结果。
部署灵活性
YOLO 模型可以导出为多种格式:
ONNX(跨平台)
TensorRT(NVIDIA GPU 优化)
CoreML(iOS 原生支持)
TFLite(Android/边缘设备)
这意味着可以实现离线识别,不需要联网等待云端响应。
系统重构后,我重新做了 A/B 测试:
测试组 A(纯大模型方案,n=200):
平均响应时间:3.8 秒
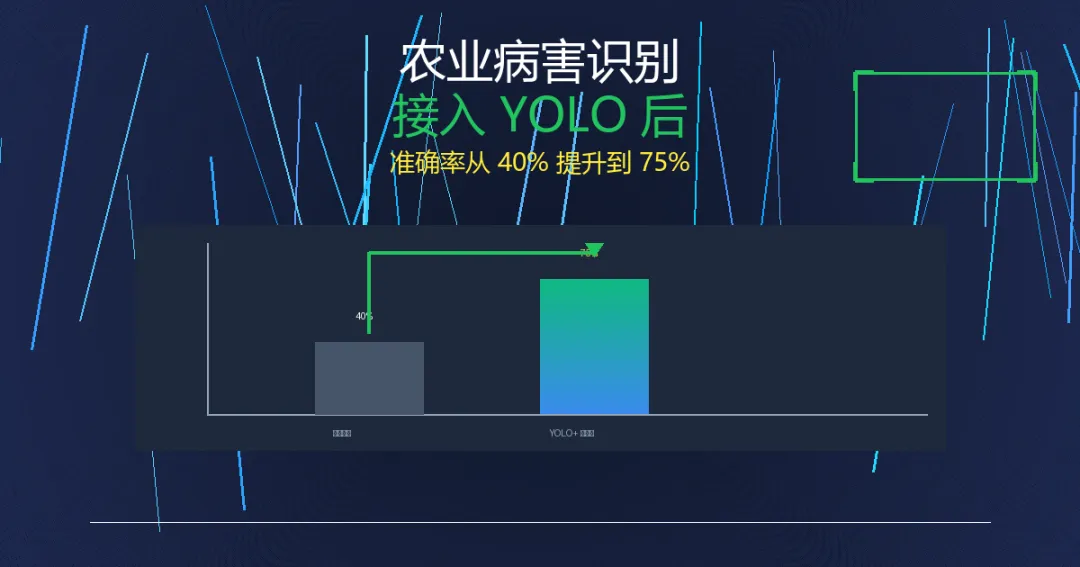
病害诊断准确率:41%
用户认为"有用"的比例:34%
测试组 B(YOLO+ 大模型 + 知识库,n=200):
平均响应时间:0.9 秒
病害诊断准确率:76%
用户认为"有用"的比例:68%
提升是实实在在的,但是远远不够,不能直接投入使用
有了好的架构,接下来是数据问题。
农业病害数据集有几个特点:
样本不均衡
常见病害(如柑橘黄龙病)的图片很多,但罕见病害的样本极少。
我的数据集中:
黄龙病图片:1200 张
溃疡病图片:800 张
某些罕见真菌病害:不到 50 张
这会导致模型对罕见病的识别能力很弱。
标注成本高
每一张图片都需要专业农技人员标注:
标注一张图片平均需要 3-5 分钟,5000 张图片就是 250-400 小时。
地域差异大
同一个病害,在不同地区表现可能不同:
广东的黄龙病 vs 江西的黄龙病
雨季的炭疽病 vs 旱季的炭疽病
大棚种植 vs 露天种植
模型在一个地区训练好,换到另一个地区效果可能大幅下降。
技术问题之外,产品设计也有很多坑。
要不要让用户确认 AI 的判断?
最初版本是直接给出诊断结果。
但发现问题:当 AI 判断错误时,用户会直接按照错误建议操作,可能造成损失。
后来改成:先展示 AI 识别出的症状,让用户确认,再给出诊断。
缺点是步骤变多了,体验变复杂了。
如何表述不确定性?
AI 的判断永远有概率,但用户想要确定的答案。
怎么说才合适?
"可能是黄龙病" → 用户觉得你不专业
"这是黄龙病" → 万一错了怎么办?
"85% 概率是黄龙病" → 用户看不懂
最后采用的方案:
"根据图像分析,高度疑似黄龙病(置信度 85%)。建议立即采取以下措施..."
同时加上免责声明:
"AI 诊断仅供参考,重大决策请咨询当地农技人员。"
收缩品类还是继续扩张?
最初想做全作物识别。
后来发现,每种作物的病害体系完全不同,知识库建设成本太高。
现在决定先聚焦单一作物(柑橘),做深做透,再考虑扩展。
这是一个艰难但必要的决定。
这三个月最大的收获,不是技术上的,而是认知上的。
认知 1:AI 不是万能的
大模型很强大,但在垂直领域,没有专业数据和知识库支撑,它就是空中楼阁。
认知 2:用户体验 > 技术指标
mAP 从 0.4 提升到 0.8 很重要,但更重要的是农户愿不愿意用、能不能真正帮到他。
认知 3:慢就是快
一开始想快速上线,结果发现返工成本更高。
不如一开始就把架构设计好,虽然慢一点,但后续迭代更顺畅。
如果你也在做农业 AI 相关的产品,我有几个建议:
别迷信大模型
大模型是很好的工具,但不是银弹。
在垂直领域,"大模型 + 专业模型 + 知识库"的组合拳更有效。
尽早接触真实用户
不要闭门造车。
去田间地头,和农户聊天,看他们怎么用手机,听他们的真实需求。
你会发现,很多你以为重要的功能,其实用户根本不在乎。
接受不完美
农业场景太复杂了,不可能做到 100% 准确。
关键是控制风险,设置合理的用户预期,建立反馈机制持续改进。
重视数据积累
模型可以买,架构可以抄,但数据只能自己积累。
越早开始收集数据,护城河越深。
现在的系统,准确率从 40% 提升到了 85%。
看起来进步很大,但离理想状态还有距离。
农户期待的是 98% 以上的准确率,是能真正指导生产决策的工具。这条路还很长。但至少,方向是对的。
YOLO 模型的引入是一个正确的起点,接下来需要在数据积累、知识库建设、用户反馈闭环上持续投入。
农业数字化是个慢生意,没有捷径,但正因为难,才值得做。
最后的话:
如果你对这个项目感兴趣,或者也在做类似的事情,欢迎交流。
 10个月宝宝每天需要喝多少奶粉?