
当前位置:首页>农业>基于多模型协作与动态加权裁决的农业科学元数据智能审核系统框架

基于多模型协作与动态加权裁决的农业科学元数据智能审核系统框架

  • 2026-10-21 04:05:30
基于多模型协作与动态加权裁决的农业科学元数据智能审核系统框架

引文格式:任有强, 赵慧, 李威, 袁欢, 樊景超, 张建华, 周国民. 基于多模型协与动态加权裁决的农业科学元数据智能审核系统框架[J]. 数据与计算发展前沿(中英文), 2026, 8(2): 171-183.

DOI:10.11871/jfdc.issn.2096-742X.2026.02.013.

文章亮点

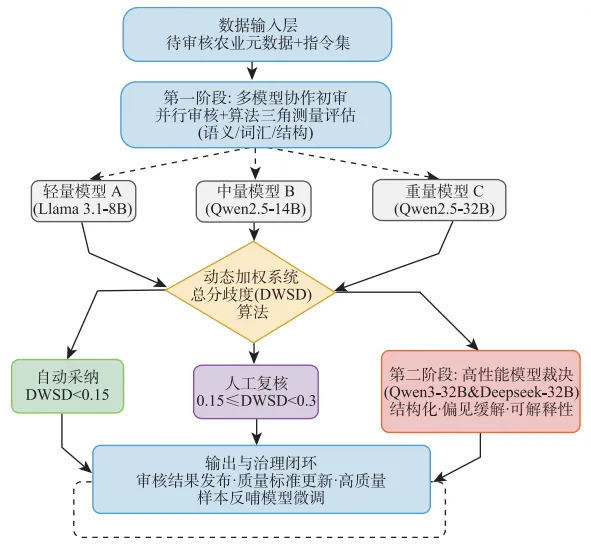
本文提出DWSD算法,将多模型间的分歧量化为可比分数,仅对高冲突样本触发裁决,以Llama3.1-8B、Qwen2.5-14B/32B三个异构模型并行初审,以架构差异为信号弥补单模型盲区;并按任务特性分别选用编辑距离、Jaccard相似度或余弦相似度进行输出评估,规避单一指标的系统性偏差。

研究背景

在农业科学数据共享的实践中,元数据的人工审核长期面临效率与质量的双重困境:现行模式下,已完成审核并发布的元数据总量不足提交总量的10%,审核周期严重滞后;与此同时,数据提交者对共享规范理解不足,导致命名不规范、分类错误、描述不充分等问题广泛存在(涉及分类错误条目超过一万条)。高质量元数据是实现FAIR原则(可查找、可获取、可互操作、可重用)的基础,也是保障科学研究可重复和跨学科数据融合的关键。因此,研发一套高效、可靠、智能的农业元数据审核系统迫在眉睫。

研究方法

图1    智能审核系统框架结构

研究结果

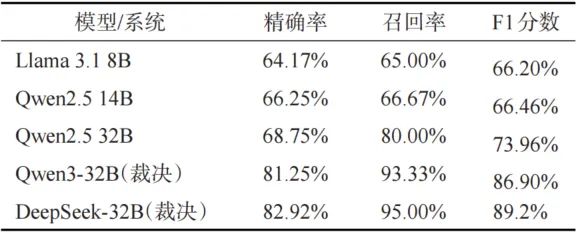
审核员对裁决模型产生的20条案例样本进行“人工逐条核对”,使用农业信息领域专家的黄金审核数据和裁决模型产生的最终数据进行比对,并依据对系统的每一次审核进行分类,最终计算出整个系统的精确率、召回率和F1分数。

表1    各基线模型与裁决系统在抽样案例性能对比分析

讨论

两个裁决模型(Qwen3-32B与DeepSeek-R1-32B)在六项任务中有五项的输出一致性达到65%~90%,T2学科分类和T5数据来源均为90%,说明两者在逻辑推断路径上存在较强的共性。

分歧最大的是T4描述内容审核(一致性65%)。事后分析发现,根本原因在于任务本身定义模糊——专家给出的"黄金标准"中混用了"准确"与"建议"等指向不同的判断词,两种架构的模型对这类语义歧义的处理方式不同,导致输出偏离。这一发现提示:在语义弹性较大的任务上,优化提示词设计和任务定义比换更强的模型更有效。

值得一提的是,人工审核员的表现并非稳定均一:T3关键词(92.5%)和T6数据类型(95%)表现良好,但T2学科分类的准确率仅45%,与AI模型在同一任务上的表现差距显著。这说明人工审核在某些结构化判断任务上本身存在认知局限,并非只是效率问题。

研究结论

本研究的核心贡献是:提出了一套可在本地部署、无需全量依赖高算力模型的分层审核机制。通过DWSD算法将计算资源集中用于真正有争议的样本,兼顾了审核质量与运行成本。在真实数据集上,该框架的F1分数超越最优基线模型15.24个百分点,也超过了人工审核员的基准水平,具备实际应用条件。框架的模块化设计使其具备扩展至其他语言、其他学科数据质量治理场景的潜力,后续可结合增量微调和因果推断等方向继续深化。

作者简介

任有强

中国农业科学院农业信息研究所/农业农村部农业大数据重点实验室,硕士研究生,研究方向为农业信息技术。

樊景超

中国农业科学院农业信息研究所,博士,副研究员,研究方向为农业大数据。

相关文章推荐

点击左下角,阅读原文

最新文章

随机文章