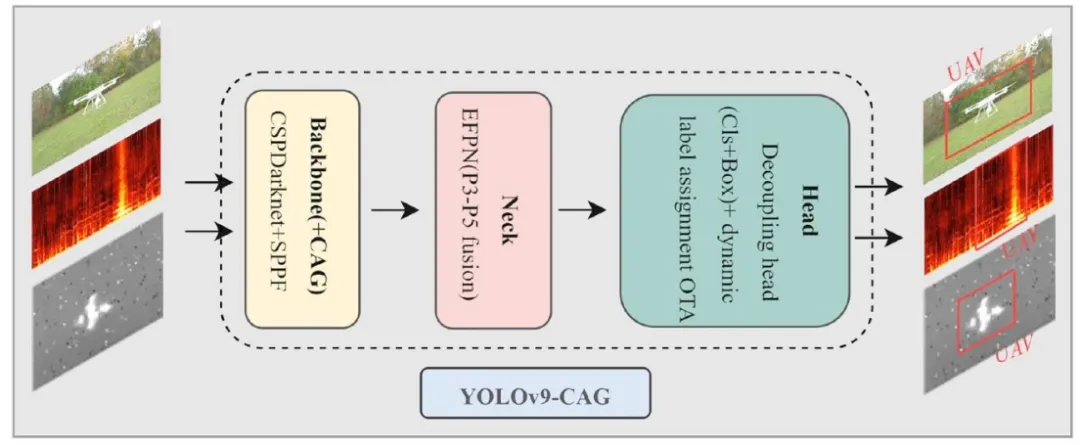
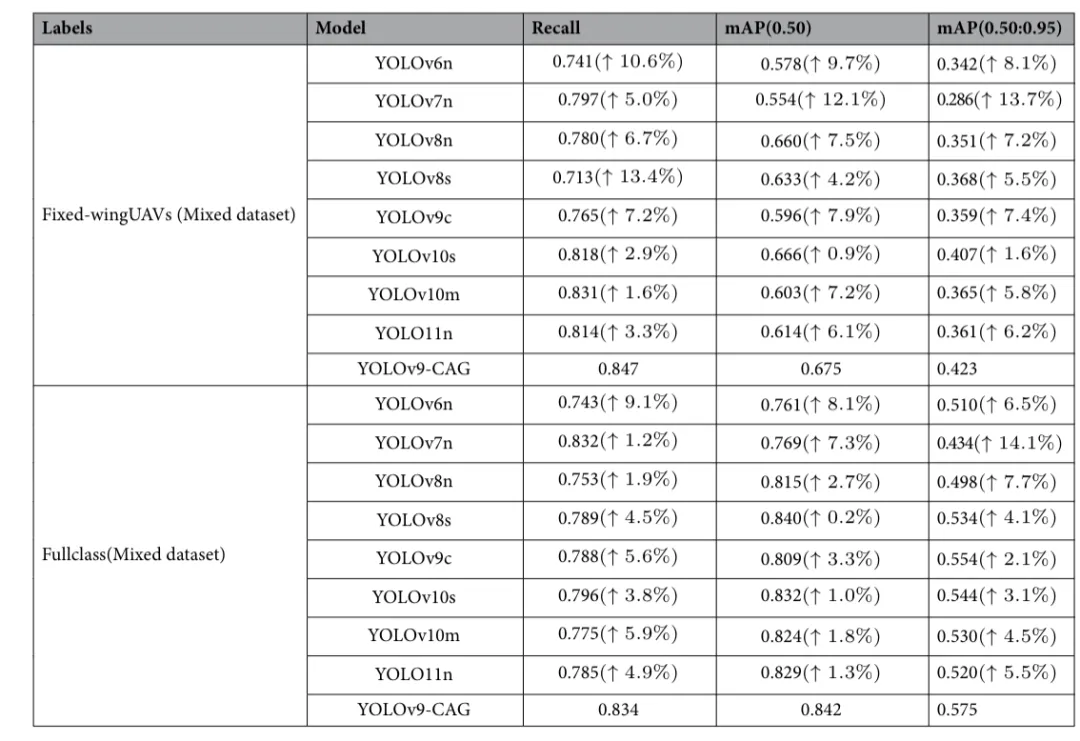
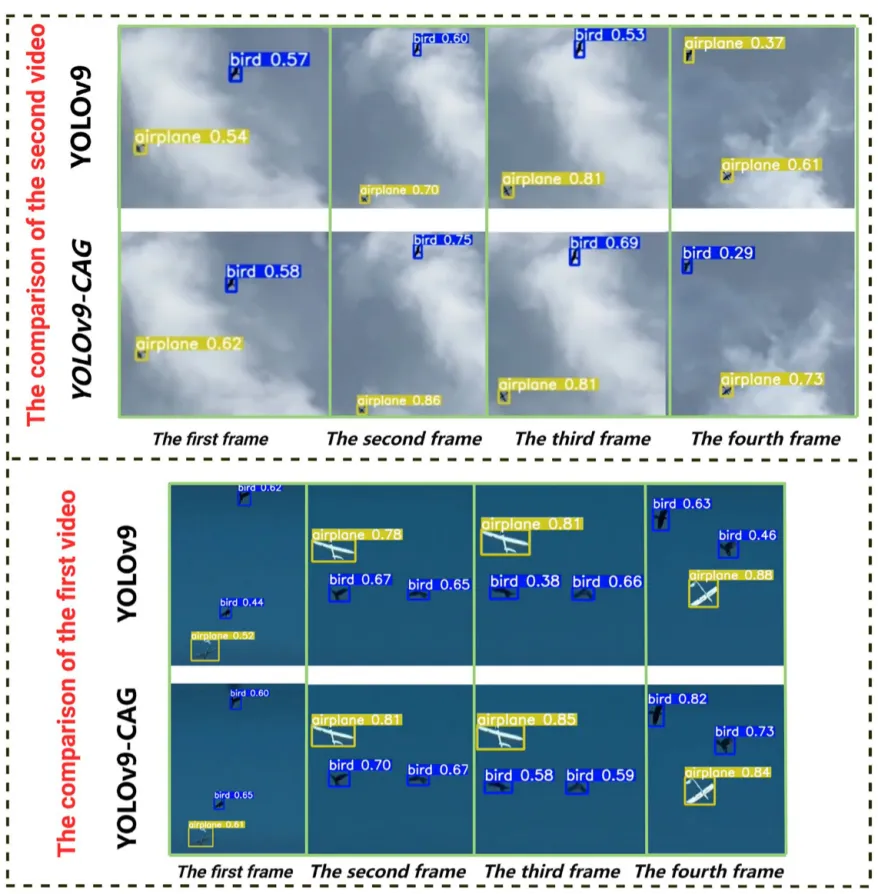
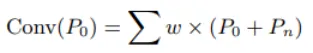本研究的整体架构如图1所示。框架首先接收多源输入(包括可见光、音频和红外图像),并使用YOLOv9-CAG执行目标检测。该模型具有CAG增强型骨干网络、基于EFPN(融合P3-P5特征)的颈部网络以及通过OTA实现动态标签分配的解耦头部。通过利用多源感知数据,该框架有效提高了复杂环境中小型无人机的检测准确率。
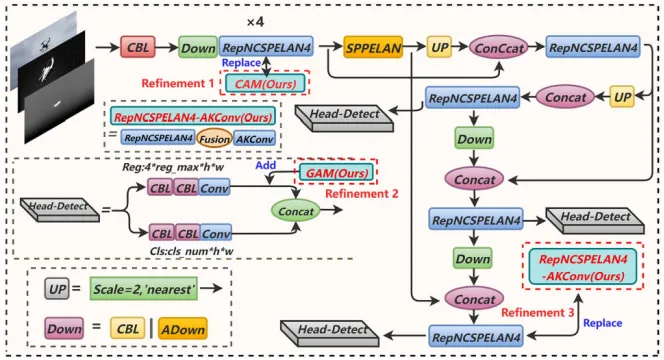
YOLOv9的创新架构使其在高精度识别任务中极具效能。其主要组件包括骨干网络RepNSCPELAN4和解耦头部结构。在此基础上,本研究提出的增强型YOLOv9-CAG模型如图2所示。
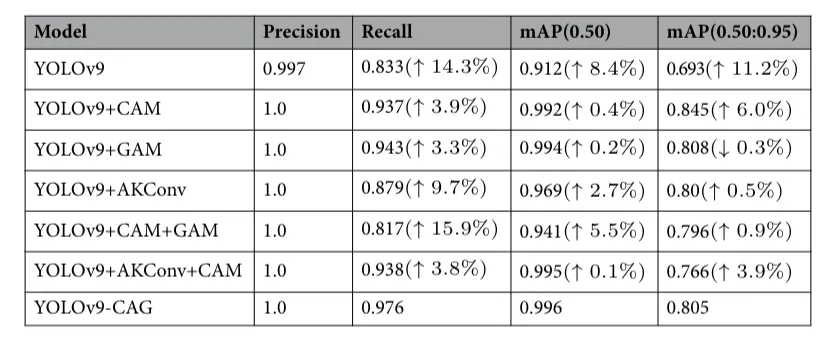
该图展示了三项重要的特征改进:在骨干网络中集成了类激活映射(CAM);在头部网络的中间部分引入了全局注意力机制(GAM);头部网络的最后一层被替换为RepNSCPELAN4-AKConv模块。
这三个模块显著增强了模型的特征提取能力,尤其是在小目标检测方面。这一改进使得对空中各类无人机的识别准确率显著提升,同时保持了推理速度。在YOLOv9架构中,RepNCPELAN4模块用于高效特征提取。该模块增强了卷积层,以同时提升模型的特征表示能力和计算效率。RepNCPELAN4包含三个关键特征:首先,采用了RepConv机制,这是一种重参数化卷积。训练时,它利用多分支卷积结构来增强特征多样性;推理时,简化为单分支以提高计算效率。其次,集成了NC(颈部复合)结构,通过连接骨干网络和检测头部的复杂特征融合模块来增强多尺度特征。最后,PELAN4(路径增强局部聚合网络v4)模块引入了额外的局部连接和跨层跳跃连接,使模型即使经过多层处理后仍能保留丰富的细节和空间信息。
Head-Detect模块也是一个重要组件,负责预测并输出头部检测结果。该模块采用多任务头部设计,使每个检测头部能同时输出类别标签、位置回归值和置信度分数,从而提高检测效率。Head-Detect集成了特征金字塔网络(FPN)和路径聚合网络(PAN),促进了不同尺度特征图之间的信息交换。这种集成有效提升了模型同时检测大、小目标的能力。此外,Head-Detect引入了动态特征加权机制,利用动态卷积自动调整权重。这使模型能够自适应地关注输入图像中的关键感兴趣区域。
CAM特征增强模块
为增强模型对无人机的分类和定位能力,本研究采用类激活映射(CAM)并将其集成于检测头部末端。具体而言,在骨干网络末端集成CAM比在前端或中间层等更早阶段集成具有显著优势。这是因为骨干网络末端生成的特征图包含丰富的语义信息,而早期特征图主要由底层信息构成,可能引入不必要的噪声并影响特征提取的有效性。因此,后期生成的特征图更适合全局上下文建模,有助于提高复杂场景下的识别准确率,这在涉及小目标和远距离目标定位的任务中尤为明显。
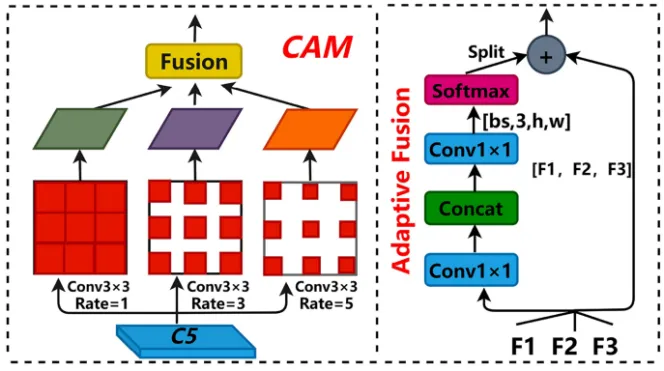
本研究中的CAM主要由两个组件构成。上下文感知模块,用于增强CAM并细化特征网络。如图3所示,CAM以不同速率捕获同一感受野的上下文信息,这对C5模块的集成至关重要。该方法有助于识别图像中的关键特征区域。采用的卷积核大小为3×3,卷积速率设为1、3和5。CAM采用三种特征融合技术:Weight(加权)、Adaptive(自适应)和Concat(拼接)。在这些方法中,自适应融合技术在准确率上的提升最为显著。自适应融合结构通过对浅层和深层特征自适应分配权重,有效整合细节信息和语义内容。浅层特征强调细节和空间位置信息,深层特征通过特征卷积、特征融合和Softmax操作封装更丰富的语义内容。这两种特征的加权融合增强了模型的多尺度感知能力,使其在各种场景中能更准确地聚焦目标区域,从而提升分类和检测任务的整体性能。通过大量实验,本研究证明,将CAM的自适应融合方法集成到原始YOLOv9骨干网络的最后一层,可显著增强模型的特征提取能力。这种改进在复杂环境中对无人机和小型鸟类目标关键特征的提取上尤为突出。
GAM注意力机制
为增强模型对图像中关键特征和关键区域的关注度,从而提升其在无人机视觉任务中的性能,本研究引入了全局注意力机制(GAM)。GAM对输入特征图提供自适应全局视角,使模型能更有效地聚焦图像的关键区域,同时降低干扰元素的影响。在无人机检测应用中,该机制可让模型更关注无人机的细微特征,从而提高对小型和远距离目标的识别准确率。
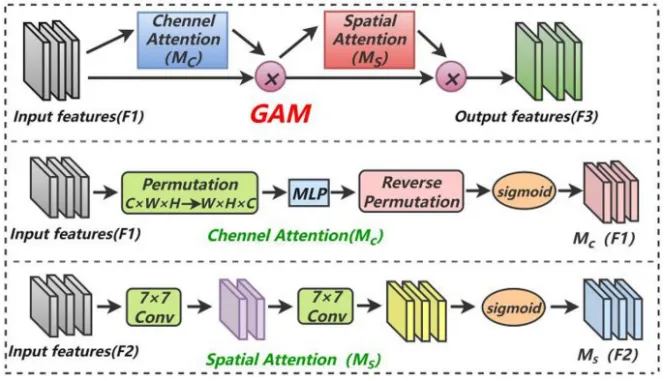
图4展示了GAM注意力机制,它同时集成了通道注意力和空间注意力。首先,通道注意力机制采用全局平均池化和最大池化来分析输入特征图的每个通道,有效聚合与每个通道相关的全局信息。随后,池化结果通过一个两层全连接网络传递,其中利用激活函数(如sigmoid)为每个通道生成权重。这些权重反映了每个通道相对于当前任务的重要性差异。最后,这些权重被依次与原始特征图的通道相乘,以调节每个通道的响应强度。这一过程有助于增强重要的通道特征,同时抑制不太重要的特征。空间注意力的过程始于沿通道维度对输入特征图进行聚合,通常采用平均池化和最大池化技术生成两个二维特征图。然后将这两个特征图结合,形成全面的空间特征表示。随后,利用小卷积核(如7×7)对生成的特征图进行卷积,得到空间权重图。该权重图指示了各个空间位置的显著性,并与经过通道注意力处理的特征图逐元素相乘。这一操作使模型能更专注于图像中重要的空间区域。在两种注意力机制分别完成各自任务后,GAM模块的输出特征图在通道和空间维度上均得到优化,从而在分类、检测等任务中提升模型性能,同时确保较高的计算效率和良好的可解释性。
GAM注意力机制被集成到YOLOv9头部网络的中间位置,以更好地突出关键特征。这种战略性布局旨在增强关键特征的特征提取能力。如果将GAM置于前端,它可能会过早强调早期特征图中的低级特征,潜在地降低模型的整体学习效果。相反,若将其置于后端,虽然特征图包含更丰富的语义信息,但精细细节可能已丢失,使得准确定位小型目标或复杂背景中的目标变得更加困难。通过将其置于头部网络的中间位置,GAM可以在深层语义特征完全形成之前,有效整合局部和全局特征,使模型能够聚焦于最重要的区域。
AKConv动态卷积
在无人机识别中,其外观和飞行模式可能存在显著差异,尤其是在复杂场景和远距离检测时。传统静态卷积方法往往难以适应这些尺度和形状的变化,导致识别准确率下降。AKConv方法通过动态调整卷积核来克服这一局限,能够灵活适应不同目标的特征尺度变化。这增强了模型的特征提取和识别能力,显著提升了无人机识别性能。
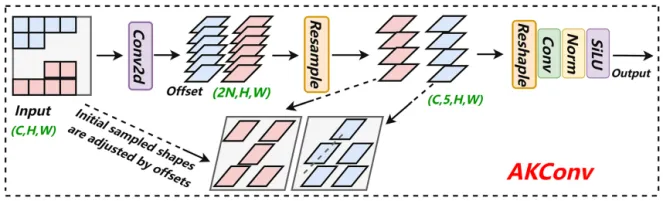
通过集成注意力机制,AKConv可根据输入特征聚焦更相关的特征区域,从而提高卷积操作的效率。首先,AKConv对输入特征图执行标准卷积,进行初步特征采样。该操作对应的卷积公式如下:
其中w表示卷积参数,Pn表示不规则卷积的初始坐标。
然后,通过全局上下文提取和注意力机制的实施,生成与输入相关的注意力权重。这些权重被用于动态调整卷积核的形状和大小。卷积操作利用这一动态生成的卷积核来实现,同时通过基于范数的归一化技术确保数据稳定性。最后,多尺度特征的加权求和结果通过SIU激活函数激活,最终输出。整个过程通过使用动态卷积核能够适应各种输入,其工作流程如图5所示。
在本研究中,AKConv动态卷积被集成在模型头部结构的末端。由于该位置的特征图维度相对较小,将AKConv置于此处而非网络的其他部分,有助于降低计算成本。此外,将AKConv集成到头部网络的尾部可提高检测准确率并最大程度减少背景干扰。在这一阶段,网络已经提取了丰富的高层语义特征。结合AKConv自适应调整卷积核的能力,它可以更精确地处理目标特征,尤其是小型目标和复杂背景下的精细细节。因此,在头部网络末端添加AKConv动态卷积有助于更好地整合全局信息,从而提高检测准确率并减少背景噪声。